
Richards & Ford – Fundamentos da Arquitetura de Software (2024)
Página 171
Design do Serviço e Granularidade
Página 172

Página 173
Particionamento do Banco de Dados
Página 174
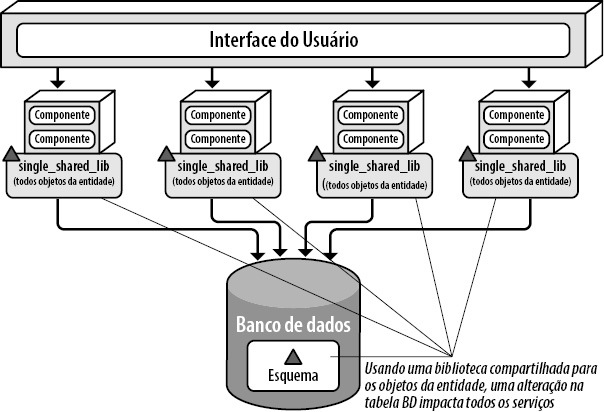
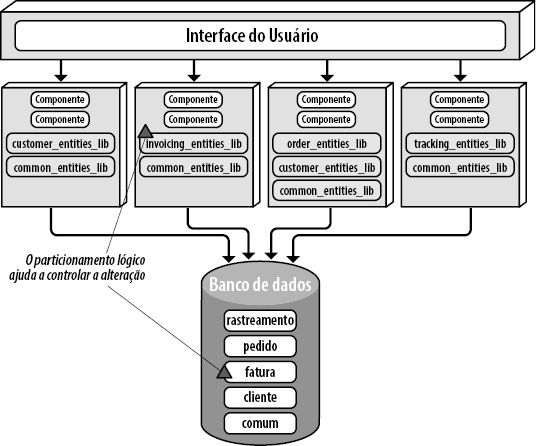
Figura 13-6. Usando uma biblioteca compartilhada para os objetos de entidade do banco de dados Um modo de amenizar o impacto e o risco das alterações no banco de dados é particioná-lo logicamente e manifestar o particionamento lógico por meio de bibliotecas compartilhadas e federadas. Observe na Figura 13-7 que o banco de dados é particionado logicamente em cinco domínios separados (comum, cliente, fatura, pedido e rastreamento). Observe também que existem cinco bibliotecas correspondentes compartilhadas e usadas pelos serviços do domínio que correspondem às partições lógicas no BD. Usando essa técnica, as alterações em uma tabela em certo domínio lógico (nesse caso, a fatura) coincidem com a biblioteca compartilhada correspondente que contém os objetos da entidade (e possivelmente o SQL também), impactando apenas os serviços que usam essa biblioteca compartilhada, que nesse caso é o serviço de fatura. Nenhum outro serviço é impactado por essa alteração.
Página 175
Arquitetura de Exemplo
Página 176
Página 177
Classificações das Características da Arquitetura
Página 178
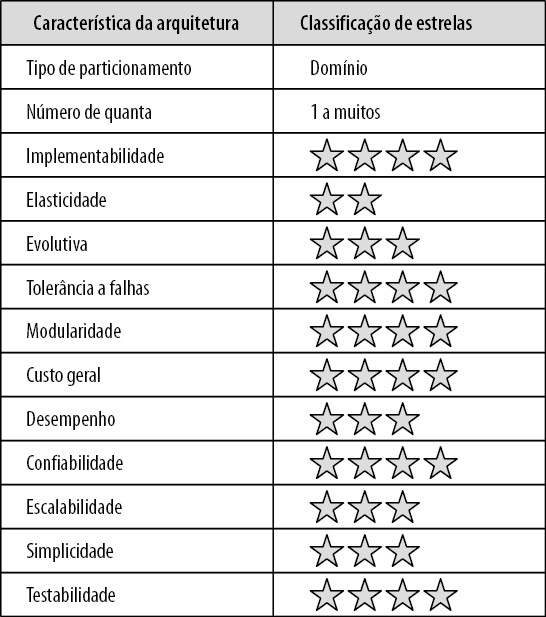
Página 179
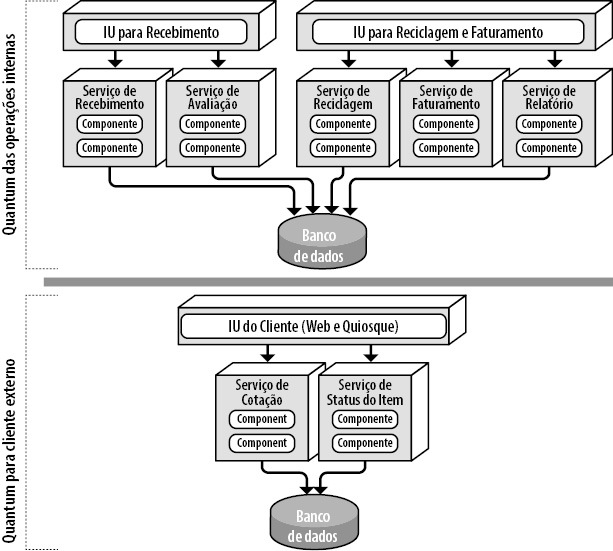
Página 180
Quando Usar Esse Estilo de Arquitetura
Página 181
Por último, a arquitetura baseada em serviços é uma boa escolha para ter um bom nível de modularidade arquitetural sem ter que entrar nas complexidades e nas armadilhas da granularidade. Conforme os serviços ficam mais granulares, começam a aparecer problemas em torno da orquestração e da coreografia. As duas são requeridas quando vários serviços devem ser coordenados para concluir certa transação comercial. Orquestração é a coordenação de vários serviços com o uso de um serviço mediador separado que controla e gerencia o fluxo de trabalho da transação (como o maestro em uma orquestra). Já a coreografia é a coordenação de vários serviços pelos quais cada serviço se comunica com outro sem usar um mediador central (como os dançarinos em uma dança). Conforme os serviços ficam mais granulares, a orquestração e a coreografia são necessárias para ligar os serviços e concluir a transação comercial. Contudo, como os serviços em uma arquitetura baseada em serviços tendem a ser mais granulares, eles não requerem tanta coordenação quanto as outras arquiteturas distribuídas.
Página 182
14. Estilo de Arquitetura Orientada a Eventos
CAPÍTULO 14 Estilo de Arquitetura Orientada a Eventos O estilo de arquitetura orientada a eventos é uma arquitetura assíncrona distribuída e popular usada para produzir aplicativos de alto desempenho e escala. Também é altamente adaptável e pode ser usada para pequenos aplicativos, além dos grandes e complexos. Essa arquitetura é composta de componentes de processamento de eventos desacoplados que recebem e processam os eventos de modo assíncrono. Pode ser usada como um estilo de arquitetura independente ou incorporado em outros estilos de arquitetura (como uma arquitetura de microsserviços orientada a eventos).
A maioria dos aplicativos segue o chamado modelo baseado em requisição (mostrado na Figura 14-1). Nesse modelo, as requisições feitas ao sistema para realizar alguma ação são enviadas para um orquestrador de requisição. Esse orquestrador costuma ser uma IU, mas também pode ser implementado por uma camada API ou barramento de serviços corporativos. A função do orquestrador é direcionar de formas determinista e síncrona a requisição para vários processadores de requisição. Os processadores lidam com a requisição, recuperando ou atualizando as informações em um banco de dados.
Um bom exemplo de modelo baseado em requisição é a de um cliente para recuperar seu histórico de pedidos nos últimos seis meses. Recuperar as informações do histórico é uma requisição baseada em dados e determinista feita ao sistema para obter dados em certo contexto, não um evento que ocorre e ao qual o sistema deve reagir.
Já um modelo orientado a eventos reage a certa situação e toma uma ação segundo esse evento.
Um exemplo de modelo orientado a eventos é enviar um lance para certo item em um leilão virtual. Enviar o lance não é uma requisição feita ao sistema, mas um evento que ocorre após o valor pedido atual ser anunciado. O sistema deve responder ao evento comparando o lance com os outros recebidos ao mesmo tempo para determinar quem é o proponente atual mais alto.
Página 183
Figura 14-1. Modelo baseado em requisição Topologia Existem duas topologias primárias na arquitetura orientada a eventos: topologia do mediador e topologia do broker. A topologia do mediador normalmente é usada quando se requer controle sobre o fluxo de trabalho de um processo de evento, ao passo que a topologia do broker é usada quando se requer um alto grau de resposta e controle dinâmico sobre o processamento de um evento. Como as características da arquitetura e as estratégias de implementação diferem entre essas duas topologias, é importante entender cada uma para saber qual é mais adequada para determinada situação.
Topologia
Topologia do broker
do broker A topologia do broker difere da do mediador no sentido de que não há um mediador do evento central. Pelo contrário, o fluxo de mensagens é distribuído nos componentes do processador do evento em uma transmissão em cadeia por meio de um message broker leve (como RabbitMQ, ActiveMQ, HornetQ etc.) Essa topologia é útil quando você tem um fluxo de processamento de evento relativamente simples e não precisa de uma orquestração e uma coordenação dos eventos centrais.
Existem quatro componentes da arquitetura primários na topologia do broker: um evento iniciador, o broker do evento, um processador do evento e um evento de processamento. O evento iniciador é o evento inicial que inicia o fluxo de eventos inteiro, sendo um evento simples, como dar um lance em um leilão virtual, ou eventos mais complexos em um sistema de benefícios de saúde, como mudar de trabalho e se casar. O evento iniciador é enviado para um canal de evento no broker do evento para processamento. Como não há nenhum componente mediador na topologia do broker gerenciando e controlando o evento, um único Processador de Eventos Aceita o evento iniciador a partir do broker do evento e começa a processar o tal evento. O processador que aceitou o evento iniciador realiza uma tarefa específica associada ao processamento desse evento, então divulga de modo assíncrono o que fez ao resto do sistema criando o chamado evento de processamento. Então esse evento é enviado de modo assíncrono para o broker para mais processamento, se necessário. Os outros processadores de evento
Página 184
Página 185
Página 186
Página 187
Página 188
Topologia do Mediador
Vantagens DesvantagensVantagens Desvantagens Processadores de eventos altamente desacoplados Controle do fluxo de trabalho Alta escalabilidade Tratamento de erro Alta resposta Recuperação Alto desempenho Capacidades para reiniciar Alta tolerância a falhas Inconsistência dos dados Topologia do Mediador A topologia do mediador da arquitetura orientada a eventos lida com uma das deficiências da topologia do broker descrita na seção anterior. No centro dessa topologia está um mediador do evento que gerencia e controla o fluxo de trabalho para os eventos iniciadores que requerem a coordenação de múltiplos processadores de eventos. Os componentes da arquitetura que formam a topologia do mediador são um evento iniciador, uma fila de eventos, um mediador do evento, canais e processadores de eventos.
Como na topologia do broker, o evento iniciador é aquele que inicia todo o processo do evento.
Diferentemente da topologia do broker, o evento iniciador é enviado para uma fila de eventos iniciadores, que é aceita pelo mediador do evento. O mediador só conhece as etapas envolvidas no processamento do evento, portanto gera eventos de processamento correspondentes que são enviados para canais do evento dedicados (em geral filas) em uma estilo de mensageria ponto a ponto. Então os processadores de eventos atendem nos canais do evento dedicados, processam o evento e, normalmente, respondem de volta ao medidor informando que concluíram o trabalho. Diferentemente da topologia do broker, os processadores de eventos na topologia do mediador não divulgam o que fizeram para o resto do sistema. A topologia do mediador é mostrada na Figura 14-5.
Figura 14-5. Topologia do mediador Na maioria das implementações da topologia do mediador, existem vários mediadores, em geral associados a certo domínio ou grupo de eventos. Isso reduz o único ponto de falha associado a essa topologia e também aumenta a taxa de transferência e o desempenho em geral. Por exemplo, pode haver um mediador do cliente que lida com todos os eventos relacionados ao cliente (como um novo registro do cliente e atualização do perfil) e outro mediador que lida
Página 189
Página 190
Página 191
Página 192
Página 193
Página 194
Página 195
Página 196
Página 197
mais, na topologia do mediador, um comando deve ser processado, já um evento pode ser ignorado na topologia do broker.
Embora a topologia do mediador lide com os problemas associados à topologia do broker, há pontos negativos associados à topologia do mediador. Primeiro, é muito difícil modelar de forma declarativa o processamento dinâmico que ocorre em um fluxo de eventos complexos.
Como resultado, muitos fluxos de trabalho no mediador só lidam com o processamento geral, e um modelo híbrido combinando as duas topologias é usado para lidar com a natureza dinâmica do processamento de eventos complexos (como condições sem estoque ou outros erros atípicos). E mais, embora os processadores de eventos possam escalar facilmente do mesmo modo como a topologia do broker, o mediador deve escalar também, algo que às vezes produz um gargalo no fluxo geral de processamento do evento. Por fim, os processadores de eventos não são tão desacoplados na topologia do mediador como são na topologia do broker, e o desempenho não é tão bom devido ao mediador controlando o processamento do evento. Esses trade-offs são resumidos no Quadro 14-2.
Quadro 14-2. Trade-offs da topologia do mediador Vantagens Desvantagens Controle do fluxo de trabalho Mais acoplamento dos processadores de eventos Tratamento de erro Menor escalabilidade Recuperação Menor desempenho Capacidades de reinício Menor tolerância a falhas Melhor consistência dos dados Modelagem do fluxo de trabalho complexo A escolha entre as topologias do broker e do mediador basicamente se resume a um trade-off entre o controle do fluxo de trabalho e a capacidade de tratamento de erro versus alto desempenho e escalabilidade. Embora o desempenho e a escalabilidade ainda sejam bons na topologia do mediador, eles não são tão altos na topologia do broker.
Capacidades Assíncronas
O estilo de arquitetura orientado a eventos oferece uma característica única em relação aos outros estilos de arquitetura, no sentido de que conta unicamente com a comunicação assíncrona para o processamento fire-and-forget (nenhuma resposta requerida), assim como o processamento de requisição/resposta (resposta requerida do consumidor de eventos). A comunicação assíncrona pode ser uma técnica poderosa para aumentar a resposta geral do sistema.
Considere o exemplo mostrado na Figura 14-13, em que um usuário posta um comentário no site para certa avaliação do produto. Pressuponha que o serviço de comentário neste exemplo leve 3 mil milissegundos para postar o comentário porque passa por vários mecanismos de análise: um verificador ortográfico para verificar palavras não aceitas, um verificador gramatical para assegurar que as estruturas das frases não tenham nada abusivo e, finalmente, um verificador de contexto para assegurar que o comentário seja sobre certo produto e não apenas um discurso político. Note, na Figura 14-13, que o caminho superior utiliza uma chamada RESTful síncrona para postar o comentário: 50 milissegundos na latência para o serviço receber a postagem, 3 mil milissegundos para postar o comentário e 50 milissegundos na latência da rede para responder ao usuário que o comentário foi postado. Isso cria um
Página 198
tempo de resposta para o usuário de 3.100 milissegundos para postar um comentário. Agora veja o caminho inferior e note que, usando uma mensageria assíncrona, o tempo de resposta da perspectiva do usuário final para postar um comentário no site é de apenas 25 milissegundos (em oposição a 3.100 milissegundos). Ainda leva 3.025 milissegundos para postar o comentário (25 milissegundos para receber a mensagem e 3 mil para postar o comentário), mas da perspectiva do usuário final, já terminou.
Figura 14-13. Comunicação síncrona versus assíncrona É um bom exemplo da diferença entre resposta e desempenho. Quando o usuário não precisa de nenhuma informação retornada (diferentemente de uma confirmação ou de uma mensagem de agradecimento), por que fazê-lo esperar? A resposta é sobre notificar o usuário sobre a ação que foi aceita e será processada no momento, já o desempenho é sobre tornar mais rápido o processo de ponta a ponta. Note que nada foi feito para otimizar como o serviço de comentário processa o texto; nos dois casos, ele ainda leva 3 mil milissegundos. Lidar com o desempenho teria otimizado o serviço de comentário para executar todos os mecanismos de análise de texto e gramática em paralelo ao uso do cache e outras técnicas semelhantes. O exemplo inferior, na Figura 14-13, lida com a resposta geral do sistema, mas não com o desempenho dele.
A diferença no tempo de resposta entre os dois exemplos, na Figura 14-13, de 3.100 milissegundos para 25 milissegundos é impressionante. Mas há um problema. No caminho assíncrono mostrado no topo do diagrama, o usuário final tem a garantia de que o comentário foi postado. Mas no caminho inferior, existe apenas a confirmação da postagem, com uma futura promessa de que o comentário será postado depois. Da perspectiva do usuário final, o comentário foi postado. Mas o que acontece se ele digitou uma palavra errada no comentário?
Nesse caso, o comentário seria rejeitado, mas não há meios de retornar ao usuário final. Ou há?
Neste exemplo, pressupondo que o usuário está registrado no site (ele teria que estar para postar um comentário), uma mensagem poderia ser enviada a ele indicando um problema no comentário e algumas sugestões de correção. É um exemplo simples. E o exemplo complicado em que a compra de uma ação ocorre de modo assíncrono (chamado negociação da ação) e não há meios de voltar para o usuário?
O principal problema nas comunicações assíncronas é o tratamento de erro. Embora a resposta seja muitíssimo melhor, é difícil lidar com as condições de erro, adicionando complexidade ao
Página 199
sistema orientado a eventos. A próxima seção explica esse problema com um padrão de arquitetura reativa chamado padrão evento de fluxo de trabalho (event workflow).
Tratamento de Erro
O padrão do evento de fluxo de trabalho da arquitetura reativa é um modo de lidar com questões associadas ao tratamento de erro em um fluxo de trabalho assíncrono. Esse padrão é uma arquitetura reativa e lida com a resiliência e com a resposta, ou seja, o sistema pode ser resiliente em termos de tratamento de erro sem impactar a resposta.
O padrão do evento do fluxo de trabalho utiliza a delegação, a conteinerização e o reparo usando um representante do fluxo de trabalho, como mostrado na Figura 14-14. O produtor de eventos passa os dados de modo assíncrono por um canal de mensagem até o consumidor de eventos. Se o consumidor tem um erro ao processar os dados, ele imediatamente delega o erro ao processador do fluxo de trabalho e vai para a próxima mensagem na fila de eventos. Assim, a resposta geral não é impactada porque a próxima mensagem é processada de imediato. Se o consumidor de eventos gastasse tempo tentando descobrir o erro, então ele não leria a próxima mensagem na fila, impactando a resposta não apenas da próxima mensagem, mas de todas as outras que aguardam na fila para serem processadas.
Assim que o processador do fluxo de trabalho recebe um erro, ele tenta descobrir o que está errado na mensagem. Poderia ser um erro estático e determinista ou ele poderia utilizar algoritmos do aprendizado de máquina para analisar a mensagem e ver alguma anomalia nos dados. De qualquer modo, o processador do fluxo de trabalho faz alterações programáticas (sem intervenção humana) nos dados originais para tentar corrigir, então retorna para a fila de origem. O consumidor de eventos vê essa mensagem como nova e tenta processá-la de novo, na esperança de ter sucesso desta vez. Naturalmente, há muitos momentos em que o processador do fluxo de trabalho não consegue determinar o que está errado na mensagem. Nesses casos, o processador envia a mensagem para outra fila, que então é recebida no que normalmente se chama “dashboard”, um aplicativo que lembra o Outlook da Microsoft ou o Mail da Apple.
Esse painel costuma ser encontrado na área de trabalho de alguém importante, que então vê a mensagem, faz correções manuais nela e a retorna para a fila original (em geral, por meio de uma variável do cabeçalho da mensagem de resposta ou reply-to).
Página 200
Figura 14-14. Padrão do evento do fluxo de trabalho na arquitetura reativa Para ilustrar o padrão do evento do fluxo de trabalho, pressuponha que um consultor de investimento em uma parte do país aceita pedidos de negociação (instruções sobre qual ação comprar e quantas cotas) em nome de uma grande empresa de trading em outra parte do país.
O consultor faz lotes dos pedidos de negociação (que, em geral, se chama carteira) e as envia de modo assíncrono para a grande empresa colocar com um broker para que a ação seja comprada. Para simplificar o exemplo, suponha que o contrato para as instruções de negociação deva seguir isto:
Imagine que a grande empresa de trading receba a seguinte carteira de ordens de negação da Apple (AAPL) do consultor de investimento:
Note que a quarta instrução de negociação (2WE35HF6DHF,BUY,AAPL,8756 SHARES) tem a palavra SHARES após o número de cotas da negociação. Quando esses pedidos de negociação assíncronas são processadas pela grande empresa sem capacidades de tratamento de erro, o seguinte erro ocorre no serviço de colocação da negociação:
Página 201
Página 202
Evitando a Perda de Dados
Página 203
Página 204
Capacidades de Transmissão
Figura 14-17. Evitando a perda de dados em uma arquitetura orientada a eventos Capacidades de Transmissão Uma das características únicas da arquitetura orientada a eventos é a capacidade de transmitir eventos sem o conhecimento de quem (se alguém) recebe a mensagem ou o que faz com ela.
Essa técnica, exibida na Figura 14-18, mostra que, quando um produtor publica uma mensagem, essa mesma mensagem é recebida por vários assinantes.
Figura 14-18. Transmitindo eventos para outros processadores de eventos Talvez a transmissão seja o nível mais alto de desacoplamento entre os processadores de eventos, porque o produtor da mensagem de transmissão normalmente não sabe quais processos do evento receberão a mensagem de transmissão e, o mais importante, o que eles farão com ela. As capacidades de transmissão são uma parte essencial dos padrões para uma eventual consistência, processamento de eventos complexos (CEP) e uma série de outras
Página 205
situações. Considere as frequentes alterações nos preços de ações para os instrumentos negociados no mercado de ações. Cada ticker (o preço atual de certa ação) pode influenciar inúmeras coisas. Contudo, o serviço que publica o último preço simplesmente o transmite sem conhecimento de como as informações serão usadas.
Requisição-Resposta
Até o momento, neste capítulo, lidamos com requisições assíncronas que não precisam de uma resposta imediata do consumidor de eventos. Mas e se uma ID do pedido for necessária ao pedir um livro? E se um número de confirmação for necessário ao marcar um voo? Esses são exemplos de comunicação entre serviços ou processadores de eventos que requerem algum tipo de comunicação síncrona.
Na arquitetura orientada a eventos, a comunicação síncrona é feita com a mensagem de requisição-resposta (às vezes referida como comunicações pseudossíncronas). Cada canal de eventos na mensagem de requisição-resposta consiste em duas filas: uma fila de requisição e uma de resposta. A requisição inicial por informações é enviada de modo assíncrono para a fila de requisição, então o controle retorna para o produtor da mensagem. O produtor faz uma espera bloqueada na fila de respostas, aguardando a resposta. O consumidor da mensagem recebe e processa a mensagem, então envia a resposta para a fila de respostas. O produtor de eventos recebe a mensagem com os dados da resposta. Esse fluxo básico é mostrado na Figura 14-19.
Figura 14-19. Processamento da mensagem de requisição-resposta Existem duas técnicas básicas para implementar a mensagem de requisição-resposta. A primeira (e mais comum) é usar a ID de correlação contida no cabeçalho da mensagem. Essa ID é um campo na mensagem de resposta que normalmente é definido para a ID da mensagem de requisição original. Essa técnica, mostrada na Figura 14-20, funciona assim, com a ID da mensagem indicada com ID e a ID de correlação indicada com CID:
Página 206
Página 207
- 3. O consumidor de eventos recebe a mensagem, processa a requisição e envia uma mensagem de resposta para a fila de resposta nomeada pelo cabeçalho reply-to.
- 4. O processador do evento recebe a mensagem e exclui a fila temporária.
Figura 14-21. Processamento da mensagem de requisição-resposta usando uma fila temporária Embora a técnica da fila temporária seja muito mais simples, o broker da mensagem deve criar uma fila temporária para cada requisição feita, então excluí-la logo depois. Grandes volumes de mensagem podem atrasar muito o broker e impactar o desempenho e a resposta em geral. Por isso, costumamos recomendar o uso da técnica da ID de correlação.
Escolhendo Entre Modelo Baseado em Requisição e Orientado a eventos
Os modelos baseados em requisição e evento são abordagens viáveis para projetar sistemas de software. Mas escolher o modelo certo é essencial para o sucesso geral do sistema.
Recomendamos escolher o modelo baseado em requisição para requisições orientadas a dados e bem estruturadas (como recuperar dados do perfil do cliente) quando é preciso ter certeza e controle sobre o fluxo de trabalho. Recomendamos escolher o modelo orientado a eventos para eventos baseados em ação e flexíveis que requerem altos níveis de responsividade e escala, com o processamento do usuário complexo e dinâmico.
Entender os trade-offs no modelo orientado a eventos também ajuda a decidir qual é mais adequado. O Quadro 14-3 lista as vantagens e as desvantagens do modelo orientado a eventos da arquitetura orientada a eventos.
Quadro 14-3. Trade-offs do modelo orientado a evento Vantagens em relação ao baseado em requisição Trade-offs Melhor resposta para conteúdo dinâmico de usuário Apenas suporta consistência eventual Melhor escalabilidade e elasticidade Menos controle sobre o fluxo do processamento Melhor agilidade e gerenciamento das alterações Menos certeza sobre o resultado do fluxo de evento Melhor adaptação e extensão Dificuldade para testar e depurar Melhor resposta e desempenho Melhor tomada de decisão em tempo real Melhor reação ao conhecimento da situação
Página 208
Arquiteturas Híbridas Orientadas a Eventos
Embora muitos aplicativos utilizem o estilo de arquitetura orientada a eventos como uma arquitetura geral primária, tal arquitetura é usada junto com outros estilos em muitos casos, formando o que é conhecido como arquitetura híbrida. Alguns estilos comuns que utilizam a arquitetura orientada a eventos como parte de outro estilo de arquitetura incluem microsserviços e arquitetura baseada em espaço. Outras híbridas possíveis incluem uma arquitetura microkernel orientada a eventos e uma arquitetura de pipeline orientada a eventos.
Adicionar uma arquitetura orientada a eventos a qualquer estilo de arquitetura ajuda a remover os gargalos, fornece um ponto de retorno nas requisições de evento com backup e oferece um nível de resposta do usuário não encontrado em outros estilos. Os microsserviços e a arquitetura baseada em espaço aproveitam a mensageria para movimentação rápida de dados em massa (do inglês, data pumps), enviando dados de modo assíncrono para outro processador que, por sua vez, atualiza os dados em um banco de dados. Eles também utilizam a arquitetura orientada a eventos para fornecer um nível de escalabilidade programática aos serviços em uma arquitetura de microsserviços e unidades de processamento em uma arquitetura baseada em espaço ao usar a mensageria para a comunicação entre os serviços.
Classificações das Características da Arquitetura
Uma estrela na tabela de classificações das características na Figura 14-22 significa que a característica específica não é bem suportada na arquitetura, já cinco estrelas significam que é um dos recursos mais fortes no estilo. A definição de cada característica identificada no painel pode ser encontrada no Capítulo 4.
A arquitetura orientada a eventos é particionada tecnicamente no sentido de que qualquer domínio em particular é distribuído em vários processadores de eventos e ligados por mediadores, filas e tópicos. As alterações em certo domínio em geral impactam muitos processadores de eventos, mediadores e outros artefatos da mensagem, e, por isso, a arquitetura orientada a eventos não é particionada por domínio.
Página 209
Figura 14-22. Classificações das características da arquitetura orientada a eventos O número de quanta na arquitetura orientada a eventos pode variar de um a muitos, que, em geral, se baseia nas interações do banco de dados em cada processador do evento e processamento de requisição-resposta. Mesmo que toda a comunicação nessa arquitetura seja assíncrona, se vários processadores de eventos compartilhassem uma única instância do banco de dados, todos estariam contidos no mesmo quantum arquitetural. O mesmo acontece no processamento de requisição-resposta: mesmo que a comunicação ainda seja assíncrona entre os processadores de eventos, se uma requisição for necessária de imediato pelo consumidor de eventos, ela vinculará esses processadores de eventos de modo assíncrono; consequentemente, eles pertencerem ao mesmo quantum.
Para ilustrar, considere o exemplo em que um processador do evento envia uma requisição para outro processador para fazer um pedido. O primeiro processador deve aguardar uma ID do pedido do outro processador para continuar. Se o segundo processador que faz o pedido e gera a ID do pedido fica inativo, o primeiro processador não pode continuar. Contudo, eles fazem parte do mesmo quantum da arquitetura e compartilham as mesmas características arquiteturais, mesmo que estejam enviando e recebendo mensagens assíncronas.
Página 210
A arquitetura orientada a eventos ganha cinco estrelas para desempenho, escalabilidade e tolerância a falhas, os pontos fortes básicos desse estilo. O alto desempenho é obtido com comunicações assíncronas combinadas com um processamento altamente paralelo. A alta escalabilidade é realizada com um equilíbrio de carga programático dos processadores de eventos (também chamado de consumidores concorrentes). Conforme a carga de requisição aumenta, processadores de eventos adicionais podem ser adicionados programaticamente para lidar com mais requisições. A tolerância a falhas é conseguida com processadores de eventos altamente desacoplados e assíncronos que fornecem uma consistência e um processamento eventuais dos fluxos de trabalho de eventos. Contanto que a IU ou um processador do evento que faz uma requisição não precise de uma resposta imediata, promessas futuras podem ser usadas para processar o evento depois, caso outros processadores subsequentes não estejam disponíveis.
A simplicidade e a testabilidade têm uma classificação baixa na arquitetura orientada a eventos, em grande parte devido a fluxos de evento não deterministas e dinâmicos normalmente encontrados nesse estilo de arquitetura. Embora os fluxos deterministas no modelo baseado em requisição sejam relativamente fáceis de testar porque os caminhos e as saídas costumam ser conhecidos, esse não é o caso no modelo orientado a evento. Por vezes, não se sabe como os processadores de eventos reagirão aos eventos dinâmicos e quais mensagens eles podem produzir. Esses “diagramas da árvore de eventos” podem ser extremamente complexos, gerando de centenas a milhares de cenários, dificultando muito seu controle e teste.
Enfim, as arquiteturas orientadas a evento são altamente evolutivas, por isso as cinco estrelas.
Adicionar novos recursos com os processadores de eventos existentes ou novos é relativamente simples, em particular na topologia do broker. Fornecendo hooks via mensagens publicadas na topologia do broker, os dados já ficam disponíveis, e nenhuma alteração é necessária na infraestrutura ou nos processadores de eventos existentes para adicionar essa funcionalidade.
Página 211
15. Estilo de Arquitetura Baseada em Espaço
CAPÍTULO 15 Estilo de Arquitetura Baseada em Espaço A maioria dos aplicativos para web segue o mesmo fluxo geral: uma requisição do navegador chega ao servidor web, então no servidor do aplicativo e, por fim, no servidor do banco de dados. Embora esse padrão funcione muito bem para um pequeno conjunto de usuários, os gargalos começam a surgir quando a carga de usuários aumenta, primeiro na camada do servidor web, depois na camada do aplicativo/servidor e, finalmente, na camada do banco de dados/servidor. A resposta usual para os gargalos baseados em um aumento na carga de usuários é escalar horizontalmente os servidores da web. Isso é relativamente fácil e barato e, por vezes, resolve esses problemas. Porém, na maioria dos casos da alta carga de usuários, escalar a camada do servidor web apenas desce o gargalo para o servidor do aplicativo. A escala dos servidores do aplicativo pode ser mais complexa e cara do que nos servidores da web, normalmente apenas descendo o gargalo para o servidor do banco de dados, que é ainda mais difícil e caro de escalar. Mesmo que você possa escalar o banco de dados, acabará com uma topologia em forma de triângulo, com a parte mais larga sendo os servidores da web (mais fáceis de escalar) e a parte menor sendo o banco de dados (mais difícil), como mostrado na Figura 15-1.
Em qualquer aplicativo de alto volume com uma carga de usuários grande e simultânea, normalmente o banco de dados será o fator limite final em quantas transações você pode processar ao mesmo tempo. Embora várias tecnologias de cache e produtos de escala do banco de dados ajudem a lidar com esses problemas, permanece o fato de que escalar horizontalmente um aplicativo normal para cargas extremas é uma proposta muito difícil.
Página 212
Figura 15-1. Limites da escalabilidade dentro de uma topologia tradicional para a web O estilo de arquitetura baseado em espaço serve especificamente para lidar com problemas que envolvem a alta escalabilidade, a elasticidade e a alta simultaneidade. Ele também é útil para aplicativos que têm volumes de usuários simultâneos variáveis e imprevisíveis. Resolver o problema da escalabilidade extrema e variável de modo arquitetural normalmente é uma abordagem melhor do que tentar escalar na horizontal um banco de dados e adaptar as tecnologias de cache em uma arquitetura não escalável.
Topologia Geral
A arquitetura baseada em espaço tem seu nome segundo o conceito do espaço de tuplas, a técnica de usar vários processadores paralelos se comunicando pela memória compartilhada. As altas escalabilidade, elasticidade e o alto desempenho são conseguidos removendo o banco de dados central como uma restrição síncrona no sistema e utilizando grades de dados em memória replicadas. Os dados do aplicativo são mantidos na memória e replicados entre todas as unidades de processamento ativas. Quando uma unidade atualiza os dados, ela os envia de modo assíncrono para o BD, em geral via mensagem com filas persistentes. As unidades iniciam e finalizam dinamicamente conforme a carga de usuários aumenta e diminui, lidando com a escalabilidade variável. Como não há um BD central envolvido no processamento transacional padrão do aplicativo, o gargalo do BD é removido, tendo uma escalabilidade quase infinita no aplicativo.
Existem vários componentes da arquitetura que formam uma arquitetura baseada em espaço:
uma unidade de processamento contendo o código do aplicativo; um middleware virtualizado usado para gerenciar e coordenar as unidades de processamento; data pumps, para enviar os dados atualizados para o banco de dados de modo assíncrono; gravações de dados, que fazem atualizações a partir dos data pumps; e leituras de dados, que leem os dados do banco de dados
Página 213
Unidade de Processamento
e os entregam às unidades de processamento na inicialização. A Figura 15-2 mostra esses componentes básicos da arquitetura.
Figura 15-2. Topologia básica da arquitetura baseada em espaço Unidade de Processamento A unidade de processamento (ilustrada na Figura 15-3) contém a lógica do aplicativo (ou partes da lógica). Em geral, inclui componentes web além da lógica de negócio de back-end. O conteúdo da unidade de processamento varia com base no tipo de aplicativo. Os aplicativos menores da web provavelmente seriam implantados em uma única unidade de processamento, já os maiores podem dividir a funcionalidade do aplicativo em várias unidades com base nas áreas funcionais dele. A unidade de processamento também pode conter serviços pequenos com finalidade única (como microsserviços). Além da lógica do aplicativo, a unidade de processamento também contém uma grade de dados em memória e um mecanismo de replicação normalmente implementado por plataformas como Hazelcast, Apache Ignite e Oracle Coherence.
Página 214
Middleware Virtualizado
Figura 15-3. Unidade de processamento Middleware Virtualizado O middleware virtualizado lida com os problemas de infraestrutura na arquitetura que controlam vários aspectos da sincronização de dados e do tratamento de requisições. Os componentes que formam o middleware virtualizado incluem grades de mensageria, de dados, de processamento e um gerenciador de implementação. Esses componentes, detalhados nas próximas seções, podem ser escritos de modo personalizado ou comprados como produtos de terceiros.
Grade de mensageria A grade de mensageria, mostrada na Figura 15-4, gerencia a requisição de entrada e o estado da sessão. Quando uma requisição entra no middleware virtualizado, o componente da grade de mensageria determina quais componentes de processamento ativos estão disponíveis para receber a requisição e envia-a para uma das unidades de processamento. A complexidade da grade de mensageria pode variar desde um algoritmo round-robin simples até o próximo algoritmo complexo disponível que controla qual requisição é processada por qual unidade de processamento. Em geral, esse componente é implementado usando um servidor web típico com capacidades de equilíbrio da carga (como HA Proxy e Nginx).
Página 215
Figura 15-4. Grade de mensageria Grade de dados O componente da grade de dados talvez seja o mais importante e essencial nesse estilo de arquitetura. Nas implementações mais modernas, a grade de dados é implementada unicamente nas unidades de processamento como um cache replicado. Mas para as implementações de cache replicado que requerem um controlador externo ou ao usar um cache distribuído, essa funcionalidade residiria nas unidades de processamento e no componente da grade de dados dentro do middleware virtualizado. Como a grade de mensageria pode encaminhar uma requisição para qualquer unidade de processamento disponível, é essencial que cada unidade contenha exatamente os mesmos dados em sua grade de dados em memória. Embora a Figura 15-5 mostre uma replicação de dados síncrona entre as unidades de processamento, na realidade isso é feito de modo assíncrono e muito rápido, em geral concluindo a sincronização dos dados em menos de 100 milissegundos.
Página 216
Página 217
Cada unidade de processamento fica ciente de todas as instâncias da unidade usando uma lista dos membros. Essa lista contém o endereço IP e as portas de todas as outras unidades de processamento que usam o mesmo cache nomeado. Por exemplo, suponha que haja uma instância de processamento com código e dados em cache replicados para o perfil do cliente.
Nesse caso, existe apenas uma instância. Portanto, a lista de membros dela contém apenas ela mesma, como mostrado nas seguintes declarações de log geradas usando Hazelcast:
Quando outra unidade de processamento inicializa com o mesmo cache nomeado, a lista dos membros dos dois serviços é atualizada para refletir o endereço IP e a porta de cada unidade de processamento:
Quando uma terceira unidade é inicializada, a lista dos membros das instâncias 1 e 2 é atualizada para refletir a terceira nova instância:
Observe que todas as três instâncias estão cientes umas das outras (inclusive de si mesmas).
Suponha que a instância 1 receba uma requisição para atualizar as informações do perfil do
Página 218
Página 219
Figura 15-6. Grade de processamento Gerenciador de implementação O componente do gerenciador de implementação controla a inicialização e a finalização dinâmicas das instâncias da unidade de processamento com base nas condições da carga. Esse componente monitora continuamente os tempos de resposta e as cargas de usuários, inicializa novas unidades de processamento quando a carga aumenta e finaliza as unidades quando a carga diminui. É um componente fundamental para realizar as necessidades de escalabilidade (elasticidade) variáveis em um aplicativo.
Data Pumps
Data pump é um modo de enviar dados para outro processador que os atualiza em um banco de dados. Eles são um componente necessário na arquitetura baseada em espaço, pois as unidades de processamento não leem nem gravam diretamente em um BD. Os data pumps nessa arquitetura são sempre assíncronos, fornecendo uma consistência eventual com o cache em memória e o banco de dados. Quando uma instância da unidade de processamento recebe uma requisição e atualiza seu cache, essa unidade se torna a proprietária da atualização e é responsável por enviar a atualização por meio do data pump para que o banco de dados possa, por fim, ser atualizado.
Em geral, os data pumps são implementados usando mensageria, como na Figura 15-7. A mensageria é uma boa escolha para os data pumps ao usar uma arquitetura baseada em espaço.
Não só tem suporte para a comunicação assíncrona, como também para uma entrega garantida, e preserva a ordem das mensagens usando a fila FIFO (first-in, first-out). E mais, a
Página 220
Gravações de Dados
Página 221
Página 222
Leituras de Dados
Figura 15-9. Gravações de dados dedicadas para cada data pump Leituras de Dados Enquanto as gravações de dados assumem a responsabilidade de atualizar o banco de dados, as leituras de dados são responsáveis por ler os dados no banco de dados e enviá-los para as unidades de processamento via data pump reverso. Na arquitetura baseada em espaço, as leituras de dados são chamadas apenas em uma dessas três situações: uma paralisação de todas as instâncias da unidade de processamento do mesmo cache nomeado, uma reimplementação de todas as unidades no mesmo cache nomeado ou ao recuperar os dados de armazenamento não contidos no cache replicado.
No caso em que todas as instâncias ficam inativas (devido a uma paralisação de todo o sistema ou à reimplementação de todas as instâncias), os dados devem ser lidos no banco de dados (algo que, normalmente, é evitado na arquitetura baseada em espaço). Quando as instâncias de uma classe da unidade de processamento começam a ficar ativas, cada uma tenta pegar um bloqueio no cache. A primeira a obter o bloqueio se torna a proprietária temporária do cache; as outras ficam em espera até o bloqueio ser liberado (isso pode variar segundo o tipo de implementação do cache usado, mas, independentemente disso, haverá um proprietário primário do cache nessa situação). Para carregar o cache, a instância que ganhou o status de proprietária temporária envia uma mensagem para uma fila solicitando os dados. O componente da leitura de dados aceita a requisição de leitura e realiza a lógica de consulta do banco de dados necessária para recuperar os dados dos quais a unidade de processamento
Página 223
precisa. Conforme a leitura dos dados consulta os dados no BD, ela os envia para uma fila diferente (chamada data pump reverso). A unidade de processamento da proprietária do cache temporária recebe os dados do data pump reverso e carrega o cache. Assim que todos os dados são carregados, a proprietária libera o bloqueio no cache, todas as outras instâncias são sincronizadas e o processamento pode iniciar. Esse fluxo de processamento é mostrado na Figura 15-10.
Figura 15-10. Leitura de dados com um data pump reverso Como as gravações de dados, as leituras também podem se basear em domínio ou ser dedicadas a uma classe específica da unidade de processamento (como costuma ser o caso). A implementação também é igual às gravações de dados, ou seja, no serviço, no aplicativo ou no hub de dados.
As gravações e as leituras de dados basicamente formam o que costuma ser conhecido como camada de abstração dos dados (ou camada de acesso dos dados em alguns casos). A diferença entre as duas é a quantidade de conhecimento detalhado que as unidades de processamento têm em relação à estrutura das tabelas (ou esquema) no banco de dados. Uma camada de acesso dos dados significa que as unidades de processamento estão acopladas às estruturas de dados subjacentes no BD e usam apenas leituras e gravações de dados para acessar indiretamente o BD. Já uma camada de abstração dos dados significa que a unidade de processamento é desacoplada das estruturas subjacentes da tabela do BD por meio de contratos separados. Em geral, a arquitetura baseada em espaço conta com o modelo da camada de abstração dos dados para que o esquema de cache replicado em cada unidade possa ser diferente das estruturas subjacentes. Isso permite alterações incrementais no BD sem impactar necessariamente as unidades de processamento. Para facilitar essa alteração incremental, as gravações e as leituras dos dados contêm uma lógica de transformação para que se um tipo de coluna mudar, uma coluna ou uma tabela for omitida, as gravações e as leituras possam armazenar em buffer a alteração no BD até as alterações necessárias serem feitas nos caches da unidade de processamento.
Colisões de Dados
Página 224
Ao usar um cache replicado em um estado ativo/ativo em que as atualizações podem ocorrer em qualquer instância do serviço contendo o mesmo cache nomeado, há a possibilidade de uma colisão de dados devido à latência da replicação. Essa colisão ocorre quando os dados são atualizados em uma instância do cache (cache A), e durante a replicação em outra instância do cache (cache B), os mesmos dados são atualizados por esse cache (cache B). Nesse caso, a atualização local no cache B será sobrescrita pela replicação dos antigos dados do cache A, e com a replicação, os mesmos dados no cache A serão sobrescritos pela atualização do cache B.
Para ilustrar o problema, pressuponha que existam duas instâncias do serviço (A e B) contendo um cache replicado do inventário do produto. O seguinte fluxo mostra o problema da colisão de dados A contagem do inventário atual dos widgets azuis é de 500 unidades O Serviço A atualiza o cache do inventário dos widgets azuis para 490 unidades (10 vendidas) Durante a replicação, o Serviço B atualiza o cache do inventário dos widgets azuis para 495 unidades (5 vendidas) O cache do Serviço B é atualizado com 490 unidades devido à replicação da atualização do Serviço A O cache do Serviço A atualiza com 495 unidades devido à replicação da atualização do Serviço B Ambos os caches nos Serviços A e B estão incorretos e sem sincronia (o inventário deveria ser de 485 unidades) Existem vários fatores que influenciam quantas colisões de dados podem ocorrer: o número de instâncias da unidade de processamento contendo o mesmo cache, a taxa de atualização do cache, o tamanho e, finalmente, a latência da replicação do produto em cache. A fórmula usada para determinar a probabilidade de quantas colisões em potencial poderiam ocorrer com base nesses fatores é:
em que N representa o número das instâncias do serviço usando o mesmo cache nomeado, UR representa a taxa de atualização em milissegundos (ao quadrado), S é o tamanho do cache (em termos de número de linhas) e RL é a latência da replicação do processo em cache.
Essa fórmula é útil para determinar a porcentagem das colisões de dados que provavelmente ocorrerão e, consequentemente, a possibilidade de usar o cache replicado. Por exemplo, considere os seguintes valores para os fatores envolvidos no cálculo:
Taxa de atualização (UR): 20 atualizações/segundo Número de instâncias (N): 5 Tamanho do cache (S): 50.000 linhas Latência da replicação (RL): 100 milissegundos Atualizações: 72.000 por hora Taxa de colisão: 14,4 por hora Porcentagem: 0,02%
Página 225
Aplicar esses fatores na fórmula produz 72 mil atualizações por hora, com uma alta probabilidade de que 14 atualizações nos mesmos dados possam colidir. Dada a baixa porcentagem (0,02%), a replicação seria uma opção viável.
Variar a latência da replicação tem um grande impacto na consistência dos dados. Essa latência depende de muitos fatores, inclusive do tipo de rede e da distância física entre as unidades de processamento. Por isso, os valores da latência raramente são publicados e devem ser calculados e derivados de medidas reais em um ambiente de produção. O valor usado no exemplo anterior (100 milissegundos) é um bom número de planejamento se a latência da replicação real, um valor que normalmente usamos para determinar a quantidade de colisões de dados, está indisponível. Por exemplo, mudar a latência da replicação de 100 milissegundos para 1 milissegundo produz o mesmo número de atualizações (72 mil por hora), mas produz apenas a probabilidade de 0,1 colisão por hora! Esse cenário é mostrado na tabela a seguir:
Taxa de atualização (UR): 20 atualizações/segundo Número de instâncias (N): 5 Tamanho do cache (S): 50.000 linhas Latência da replicação (RL): 1 milissegundo (mudou de 100) Atualizações: 72.000 por hora Taxa de colisão: 0,1 por hora Porcentagem: 0,0002% O número de unidades de processamento contendo o mesmo cache nomeado (como representado pelo fator número de instâncias) também tem uma relação proporcional direta com o número de possíveis colisões de dados. Por exemplo, reduzir o número de unidades de processamento de 5 instâncias para 2 produz uma taxa de colisão de dados de apenas 6 por hora em 72 mil atualizações por hora:
Taxa de atualização (UR): 20 atualizações/segundo Número de instâncias (N): 2 (mudou de 5) Tamanho do cache (S): 50.000 linhas Latência da replicação (RL): 100 milissegundos Atualizações: 72.000 por hora Taxa de colisão:: 5,8 por hora Porcentagem: 0,008% O tamanho do cache é o único fator que é inversamente proporcional à taxa de colisão.
Conforme o tamanho diminui, as taxas de colisão aumentam. Em nosso exemplo, reduzir o tamanho do cache de 50 mil linhas para 10 mil (mantendo todo o resto igual, como no primeiro exemplo) produz uma taxa de colisão de 72 por hora, muito mais alta do que com 50 mil linhas:
Taxa de atualização (UR): 20 atualizações/segundo Número de instâncias (N): 5 Tamanho do cache (S): 10.000 linhas (mudou de 50.000) Latência da replicação (RL): 100 milissegundos Atualizações: 72.000 por hora
Página 226
Taxa de colisão:: 72,0 por hora Porcentagem: 0,1% Sob circunstâncias normais, a maioria dos sistemas não tem taxas de atualização consistentes em um período longo de tempo. Assim, ao usar esse cálculo, seria útil entender a taxa de atualização máxima durante o uso de pico e calcular as taxas de colisão mínima, normal e de pico.
Implementações na Nuvem Versus Locais
A arquitetura baseada em espaço oferece opções únicas quanto aos ambientes nos quais é implantada. A topologia inteira, inclusive as unidades de processamento, o middleware virtualizado, data pumps, leituras/gravações de dados e o banco de dados, pode ser implantada nos locais dos ambientes baseados em nuvem. Contudo, esse estilo de arquitetura também pode ser implantado entre esses ambientes, oferecendo um recurso único não encontrado em outros estilos.
Um recurso poderoso desse estilo (mostrado na Figura 15-11) é implantar os aplicativos via unidades de processamento e middleware virtualizado nos ambientes gerenciados baseados em nuvem, mantendo os bancos de dados físicos e dados correspondentes no local. Essa topologia suporta uma sincronização de dados baseados na nuvem muito eficiente devido aos data pumps assíncronos e ao eventual modelo de consistência desse estilo. O processamento transacional pode ocorrer em ambientes de nuvem dinâmicos e elásticos, preservando o gerenciamento de dados físico, o relatório e a análise dos dados em ambientes locais e seguros.
Figura 15-11. Topologias híbridas baseadas na nuvem e no local
Página 227
Cache Replicado Versus Distribuído
A arquitetura baseada em espaço conta com o cache para o processamento transacional de um aplicativo. Remover a necessidade de leituras e gravações diretas em um BD possibilita que essa arquitetura tenha suporte para a alta escalabilidade, elasticidade e desempenho. Tal arquitetura conta muito com o cache replicado, embora o cache distribuído também possa ser usado.
Com o cache replicado, como na Figura 15-12, cada unidade de processamento contém sua própria grade de dados em memória que é sincronizada entre todas as unidades usando o mesmo cache nomeado. Quando ocorre uma atualização em um cache em qualquer unidade, as outras unidades são atualizadas automaticamente com as novas informações.
Figura 15-12. Cache replicado entre as unidades de processamento O cache replicado não é só muitíssimo rápido, como também suporta altos níveis de tolerância a falhas. Como não há nenhum servidor central mantendo o cache, o cache replicado não tem um único ponto de falha. Porém pode haver exceções à regra com base na implementação do produto em cache usado. Alguns produtos requerem a presença de um controlador externo para monitorar e controlar a replicação dos dados entre as unidades de processamento, mas a maioria das empresas de produto evita esse modelo.
Embora o cache replicado seja o modelo padrão para a arquitetura baseada em espaço, há alguns casos em que não é possível usá-lo. Essas situações incluem altos volumes de dados (tamanho do cache) e altas taxas de atualização nos dados do cache. Os caches de memória internos com mais de 100MB podem causar problemas em relação à elasticidade e à alta escalabilidade devido à quantidade de memória usada por cada unidade de processamento.
Essas unidades costumam ser implantadas em uma VM (ou, em alguns casos, representam a VM). Cada VM tem apenas certa quantidade de memória disponível para o uso do cache interno, limitando o número de instâncias da unidade de processamento que podem ser iniciadas para processar situações com alta taxa de transferência. E mais, como em “Colisões de Dados”, se a taxa de atualização dos dados de cache for muito alta, a grade de dados poderá não conseguir acompanhar essa alta taxa e assegurar a consistência dos dados em todas as instâncias da unidade de processamento. Nesses casos, o cache distribuído pode ser usado.
O cache distribuído, como na Figura 15-13, requer um servidor externo ou serviço dedicado para manter um cache centralizado. Nesse modelo, as unidades de processamento não armazenam dados na memória interna, mas usam um protocolo proprietário para acessar os
Página 228
dados a partir do servidor de cache central. O cache distribuído suporta altos níveis de consistência de dados porque os dados estão todos em um lugar e não precisam ser replicados.
Mas esse modelo tem menos desempenho do que o cache replicado porque os dados do cache devem ser acessados remotamente, aumentando a latência geral do sistema. A tolerância a falhas também é um problema no cache distribuído. Se o servidor do cache com os dados fica inativo, nenhum dado pode ser acessado ou atualizado a partir de qualquer unidade de processamento, ficando inoperante. A tolerância a falhas pode ser amenizada espelhando o cache distribuído, mas isso traria problemas de consistência se o servidor do cache primário ficasse inativo de modo inesperado e os dados não chegassem ao servidor de cache espelhado.
Figura 15-13. Cache distribuído entre as unidades de processamento Quando o tamanho do cache é relativamente pequeno (abaixo de 100MB) e a taxa de atualização do cache é baixa o bastante a ponto de o mecanismo de replicação do produto de cache poder acompanhar as atualizações do cache, a decisão entre usar um cache replicado e um distribuído se torna uma questão de consistência dos dados versus desempenho e tolerância a falhas. Um cache distribuído sempre oferecerá uma melhor consistência dos dados acima de um cache replicado porque o cache dos dados está em um único lugar (em oposição a estar distribuído em várias unidades de processamento). Porém, desempenho e tolerância a falhas sempre serão melhores ao usar um cache replicado. Muitas vezes, essa decisão se resume ao tipo de dados que é colocado em cache nas unidades de processamento. A necessidade de dados altamente consistentes (como contagens do inventário dos produtos disponíveis) costuma assegurar um cache distribuído, ao passo que, em geral, os dados que não mudam muito (como dados de referência do tipo pares de nome/valor, códigos e descrição do produto) asseguram um cache replicado para uma pesquisa rápida. Alguns critérios de seleção que podem ser usados como guia para escolher quando usar um cache distribuído versus um replicado são listados no Quadro 15-1.
Quadro 15-1. Cache distribuído versus replicado Critério de decisão Cache replicado Cache distribuído Otimização Desempenho Consistência Tamanho do cache Pequeno (< 100MB) Grande (> 500MB) Tipo de dados Relativamente estático Altamente dinâmico Frequência da atualização Reativamente baixa Alta taxa de atualização Tolerância a falhas Alta Baixa
JIM – Assistente
Jim IA: pode errar. Não digite dados pessoais. Suas mensagens são processadas por um serviço externo.